Đo độ chính xác của AI agent trên dữ liệu thật: 380 câu trả lời và khoảng tin cậy Wilson
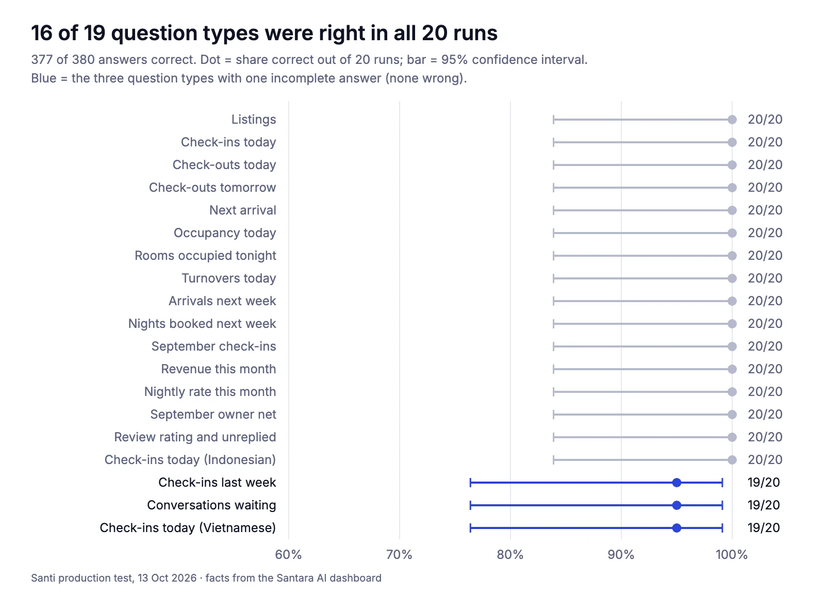
Demo cho thấy một AI agent có thể trả lời đúng. Nó không cho biết agent trả lời đúng thường xuyên đến mức nào. Bài này chia sẻ cách nhóm mình đo con số đó cho một AI agent chạy trên dữ liệu vận hành thật: 19 câu hỏi, mỗi câu hỏi 20 lần, tổng cộng 380 câu trả lời, chấm từng câu theo dữ liệu gốc, rồi tính khoảng tin cậy cho kết quả.
Bối cảnh: agent tên Santi, nằm trong phần mềm quản lý cho thuê ngắn hạn (homestay, villa). Agent trả lời câu hỏi của chủ nhà bằng cách gọi các tool chỉ đọc để lấy dữ liệu đặt phòng, hộp thư, đánh giá, doanh thu. Mình không đi sâu vào sản phẩm. Phần đáng chia sẻ là phương pháp, vì nó áp dụng được cho bất kỳ agent nào trả lời bằng số liệu.
Toàn bộ số liệu trong bài lấy từ nghiên cứu đã công bố, chạy trên bản production ngày 13/10/2026. Bản đầy đủ (tiếng Anh) ở cuối bài.
1. Vì sao phải hỏi một câu nhiều lần
LLM không xác định (non-deterministic). Cùng một câu hỏi, cùng dữ liệu, agent có thể gọi tool theo thứ tự khác, diễn đạt khác, hoặc thỉnh thoảng bỏ sót một phần. Hỏi một lần rồi thấy đúng chỉ chứng minh agent có khả năng đúng.
Muốn biết tỷ lệ đúng thì phải lặp lại. Nhóm mình chọn 20 lần cho mỗi câu, chia thành 20 vòng, mỗi vòng hỏi xoay vòng đủ 19 câu. Như vậy, nếu hệ thống chậm hoặc lỗi vào một thời điểm nào đó, ảnh hưởng sẽ rải đều cho mọi câu hỏi thay vì dồn vào một câu.
2. Thiết kế bộ câu hỏi
19 câu hỏi chia 4 nhóm, đều là câu chủ nhà hỏi hằng ngày, và đều chỉ đọc (không câu nào khiến agent thay đổi dữ liệu):
| Nhóm | Số câu | Ví dụ |
|---|---|---|
| Đếm số | 10 | Hôm nay có bao nhiêu lượt dọn phòng? Tuần sau đặt bao nhiêu đêm? |
| Tên khách | 4 | Hôm nay ai nhận phòng? Ngày mai ai trả phòng? |
| Tiền | 3 | Doanh thu tháng này? Owner net tháng 9? |
| Ngôn ngữ khác | 2 | "Hôm nay ai nhận phòng?", "Siapa yang check-in hari ini?" |
Hai câu ngôn ngữ khác thực chất là câu "ai nhận phòng hôm nay" hỏi bằng tiếng Việt và tiếng Indonesia. Mục đích là kiểm tra xem agent có trả lời đúng ngôn ngữ người hỏi và vẫn giữ đúng số liệu hay không.
3. Ba nguyên tắc khi chạy
Xóa lịch sử hội thoại sau mỗi câu trả lời. Nếu không, câu trả lời sau có thể "dựa" vào câu trước, và kết quả không còn độc lập. Đây là lỗi thiết kế test hay gặp nhất.
Gọi đúng endpoint mà app thật dùng. Nhóm mình gọi qua cùng streaming endpoint của app, đăng nhập bằng tài khoản chủ nhà. Test qua một đường riêng, "sạch" hơn production, sẽ cho kết quả đẹp hơn thực tế.
Chốt giá trị chuẩn trước khi chạy. Giá trị đúng được đọc từ chính dashboard của sản phẩm (lịch, hộp thư, trang đánh giá, báo cáo chủ sở hữu) lúc bắt đầu chạy. Agent đúng hay sai là so với các con số này, chứ không so với cảm nhận của người chấm.
Sau 380 lượt chạy tự động, cả 19 câu còn được gõ tay một lần trên giao diện chat thật trong trình duyệt, để chắc rằng không có khác biệt giữa API và UI.
4. Chấm điểm: ba mức, không phải hai
Chấm "đúng/sai" là chưa đủ, vì có những câu trả lời không sai nhưng thiếu. Nhóm mình dùng ba mức:
- Đúng: nêu đúng con số chuẩn (tiền chênh trong khoảng 1%), hoặc nêu đủ tên mọi khách, bằng đúng ngôn ngữ được hỏi.
- Thiếu: không có số liệu sai, nhưng bỏ sót một phần câu hỏi.
- Sai: nêu một con số hoặc cái tên mâu thuẫn với giá trị chuẩn.
Việc chấm là so khớp văn bản tự động. Mọi câu trả lời không được chấm "đúng" thì có người đọc lại bằng tay. Tự động hóa giúp chạy được 380 lượt, còn đọc tay giúp không bỏ lọt các trường hợp đặc biệt.
5. Khoảng tin cậy Wilson: đừng báo "0%" trần trụi
Kết quả: 0/380 câu sai. Nhưng "0% sai" không có nghĩa là agent không bao giờ sai. Với mẫu hữu hạn, nên báo kèm khoảng tin cậy.
Khoảng Wald quen thuộc (p ± z·√(p(1−p)/n)) cho ra khoảng [0%, 0%] khi p = 0. Kết quả đó vô nghĩa. Khoảng Wilson score vẫn dùng được ở mẫu nhỏ và ở 0% hay 100%:
from math import sqrt

def wilson(k: int, n: int, z: float = 1.96) -> tuple[float, float]:
    """Khoảng tin cậy Wilson 95% cho tỷ lệ k/n."""
    p = k / n
    denom = 1 + z * z / n
    center = (p + z * z / (2 * n)) / denom
    half = z * sqrt(p * (1 - p) / n + z * z / (4 * n * n)) / denom
    return center - half, center + half

print(wilson(0, 380))    # (0.0, 0.0100...)  -> sai: 0%, cận trên 1,0%
print(wilson(377, 380))  # (0.977..., 0.997...) -> đúng: 99,2%, khoảng 97,7–99,7%
print(wilson(19, 20))    # (0.763..., 0.991...)  -> câu đúng 19/20 lần
Vậy cách báo cáo trung thực là: 0/380 câu sai, khoảng tin cậy 95% là 0,0–1,0%, và 377/380 câu đúng (99,2%; 97,7–99,7%).
Dòng cuối trong đoạn code trên cũng giải thích vì sao đừng kết luận gì từ một câu riêng lẻ. Câu đúng 19/20 lần có khoảng tin cậy từ 76% đến 99%, quá rộng để so sánh câu này với câu khác.
6. Đo thời gian sao cho có nghĩa
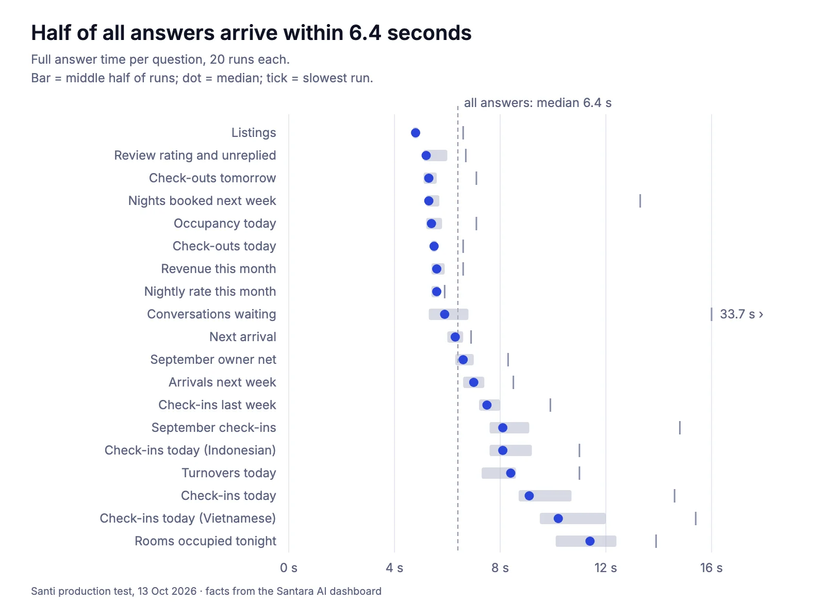
Thời gian được tính từ lúc gửi câu hỏi đến lúc câu trả lời kết thúc (wall-clock), báo bằng trung vị và khoảng tứ phân vị (IQR) thay vì trung bình. Chỉ một lượt chạy chậm bất thường cũng đủ kéo lệch trung bình.
- Trung vị đến khi có câu trả lời hoàn chỉnh: 6,4 giây (IQR 5,4–8,3 giây; phân vị 95 là 12,0 giây; chậm nhất 33,7 giây, một lượt).
- Chữ đầu tiên xuất hiện sau trung vị 4,5 giây.
- Tra một nguồn mất khoảng 5 giây. Câu phải kết hợp nhiều nguồn, như "tối nay bao nhiêu phòng có khách", mất khoảng 10 giây.
7. Phần đáng học nhất: ba câu trả lời "thiếu"
Ba câu bị chấm "thiếu", và điểm chung bất ngờ là: không câu nào do model đọc sai dữ liệu. Cả ba đều do chính quy tắc mà nhóm mình viết cho agent.
| Câu hỏi | Chủ nhà nhận được | Nguyên nhân |
|---|---|---|
| Tuần trước bao nhiêu khách nhận phòng? | Không có câu trả lời; hỏi lại thì ra đúng 14 | Model tra đúng số rồi kết thúc lượt mà không viết gì; chưa có cơ chế tự hỏi lại |
| Bao nhiêu hội thoại đang chờ trả lời? | "12 tuần này, cộng 29 cũ hơn", không có tổng 41 | Tool trả số theo hai phần, và agent được dặn không bao giờ tự cộng |
| Hôm nay ai nhận phòng? (tiếng Việt) | "Hôm nay có 3 khách", nhưng chỉ nêu tên 2 | Danh sách đã hiện trên màn hình dưới dạng thẻ, và agent được dặn không lặp lại nội dung của thẻ |
Câu thứ hai là ví dụ điển hình. "Không bao giờ tự làm phép tính" là một quy tắc đúng: nó ngăn agent cộng sai. Nhưng khi tool không trả sẵn con số tổng, chính quy tắc đó khiến câu trả lời bị thiếu. Cách sửa không nằm ở model, mà ở tool: cho tool trả luôn con số tổng.
Ngoài ra còn một câu được chấm "đúng" nhưng mở đầu bằng "18 khách nhận phòng tuần trước" rồi mới sửa lại thành 14, vì có 4 đặt phòng đã bị hủy. Con số cuối cùng đúng, nhưng câu mở đầu gây hiểu lầm. Từ lần test sau, kiểu trả lời này sẽ bị chấm là "thiếu".
Cả ba lỗi đều đã được sửa:
- lượt nào tra cứu mà không viết gì thì agent tự hỏi lại một lần;
- câu "bao nhiêu đang chờ" nêu tổng trước, rồi mới chia nhỏ;
- câu hỏi trực tiếp (ai, bao nhiêu) luôn được trả lời đầy đủ bằng chữ, kể cả khi thẻ đã hiện cùng danh sách.
Chạy lại ba câu này cùng một câu tiếng Anh đối chứng (20 lượt) cho kết quả 20/20 đúng và đủ.
8. Một cơ chế cảnh báo, và 22 lần báo nhầm
Agent có một lớp kiểm tra: con số nào trong câu trả lời không xuất hiện trong dữ liệu vừa đọc thì bị gắn cảnh báo. Trong 380 câu trả lời, lớp này bật 22 lần, và cả 22 đều rơi vào con số đúng. Đó là các số agent tính ra chứ không đọc thẳng từ dữ liệu, như tổng chi phí của một tháng (20 lượt) hay giá đêm sau khi trừ phí (2 lượt).
Nghĩa là: không bỏ sót lỗi nào, nhưng báo nhầm 22 lần. Báo nhầm vẫn tốt hơn im lặng bỏ sót. Cách khắc phục cũng giống trên: để tool trả sẵn mọi con số tổng mà agent cần.
9. Giới hạn của nghiên cứu
Nên nói rõ những gì kết quả không chứng minh:
- Chỉ chạy trên một danh mục (12 căn), trong một ngày, với một bộ giá trị chuẩn. Danh mục lớn hơn hoặc ít hoạt động hơn có thể cho kết quả khác.
- Chấm bằng so khớp văn bản, có người đọc lại các câu không đúng.
- Một giá trị chuẩn (số hội thoại trong hộp thư) thay đổi trong lúc chạy, nên được chấp nhận trong khoảng ±1.
- Lần test lại sau khi sửa nhỏ hơn (20 lượt) và chạy trên một workspace test riêng.
10. Tóm lại, nếu bạn muốn đo agent của mình
- Chọn những câu người dùng thật sự hỏi hằng ngày, không phải câu dùng để demo.
- Hỏi mỗi câu nhiều lần, xoay vòng, và xóa ngữ cảnh giữa các lần.
- Chốt giá trị chuẩn từ nguồn dữ liệu gốc trước khi chạy.
- Chấm ba mức: đúng, thiếu, sai. Đọc tay mọi câu không đúng.
- Báo cáo bằng khoảng tin cậy Wilson, không báo tỷ lệ trần trụi.
- Báo thời gian bằng trung vị và IQR.
- Khi thấy lỗi, kiểm tra tool và quy tắc của mình trước khi đổ cho model.
Bài học lớn nhất của nhóm mình: phần lớn lỗi của một AI agent trong sản phẩm thật là lỗi "đường ống" (tool trả thiếu, quy tắc chồng chéo), không phải model "bịa". Và lỗi đường ống chỉ lộ ra khi bạn kiên nhẫn hỏi đi hỏi lại những câu nhàm chán hàng trăm lần.
Nghiên cứu đầy đủ (phương pháp, bảng kết quả từng câu, phân tích lỗi), bằng tiếng Anh: https://www.santara.ai/blog/santi-accuracy-test/
All rights reserved