Đưa OpenAI từ PoC lên production: Architecture, RAG, evaluation và integration trong hệ thống doanh nghiệp
Đưa OpenAI từ PoC lên production: Architecture, RAG, evaluation và integration trong hệ thống doanh nghiệp
Tạo được một câu trả lời thuyết phục từ LLM trong môi trường demo thường không quá khó. Nhưng vận hành một ứng dụng AI ổn định, có thể kiểm soát và tích hợp vào quy trình doanh nghiệp lại là một bài toán hoàn toàn khác.
Trong PoC, dữ liệu thường đã được chọn lọc, lượng người dùng nhỏ và kết quả có thể được kiểm tra thủ công. Khi lên production, hệ thống phải làm việc với dữ liệu thật, quyền truy cập khác nhau, nhiều request đồng thời, yêu cầu latency, giới hạn chi phí và các tình huống lỗi không xuất hiện trong demo.
Vì vậy, câu hỏi trung tâm không chỉ là:
“Nên dùng model nào?”
Một câu hỏi tốt hơn là:
“Hệ thống AI cần được thiết kế như thế nào để truy cập đúng dữ liệu, tạo đầu ra có căn cứ, tích hợp với hệ thống nghiệp vụ, được đánh giá, quan sát và vận hành an toàn trong production?”
1. PoC thành công chưa có nghĩa production-ready
Một PoC thường tối ưu cho việc chứng minh use case có khả thi hay không. Production phải chứng minh rằng use case đó có thể hoạt động lặp lại trong điều kiện thực tế.
Khoảng cách giữa hai trạng thái này xuất hiện ở nhiều lớp:
- Demo quality và system reliability: một số câu trả lời tốt chưa chứng minh hệ thống ổn định trên nhiều loại input.
- Controlled data và live enterprise data: dữ liệu production thay đổi liên tục, có thể thiếu metadata, trùng lặp hoặc chứa thông tin nhạy cảm.
- Single user và concurrent usage: nhiều request đồng thời tạo áp lực lên rate limit, latency, connection và downstream services.
- Manual review và repeatable evaluation: đánh giá bằng cảm giác không đủ để phát hiện regression.
- Prototype prompt và versioned behavior: prompt, model, retrieval pipeline và tool definition đều cần được quản lý phiên bản.
Một PoC tốt trả lời “có thể làm được không?”. Một production design phải trả lời thêm “hệ thống có thể làm đúng, an toàn và có thể vận hành được hay không?”.
2. Production AI là một hệ thống, không chỉ là một model
Trong production, LLM chỉ là một thành phần của hệ thống. Một kiến trúc điển hình có thể được nhìn theo các lớp:
User / Application layer
→ API / Orchestration layer
→ Retrieval / Tools / Enterprise systems
→ Model layer
→ Logging / Evaluation / Observability
→ Governance / Security
Application layer xác định trải nghiệm người dùng và ngữ cảnh nghiệp vụ. Orchestration layer quản lý prompt, model routing, tool calling, timeout, retry và fallback. Retrieval và integration layer kết nối dữ liệu nội bộ. Model layer tạo hoặc phân tích nội dung. Các lớp observability và governance giúp hệ thống có thể được theo dõi, kiểm soát và cải tiến.
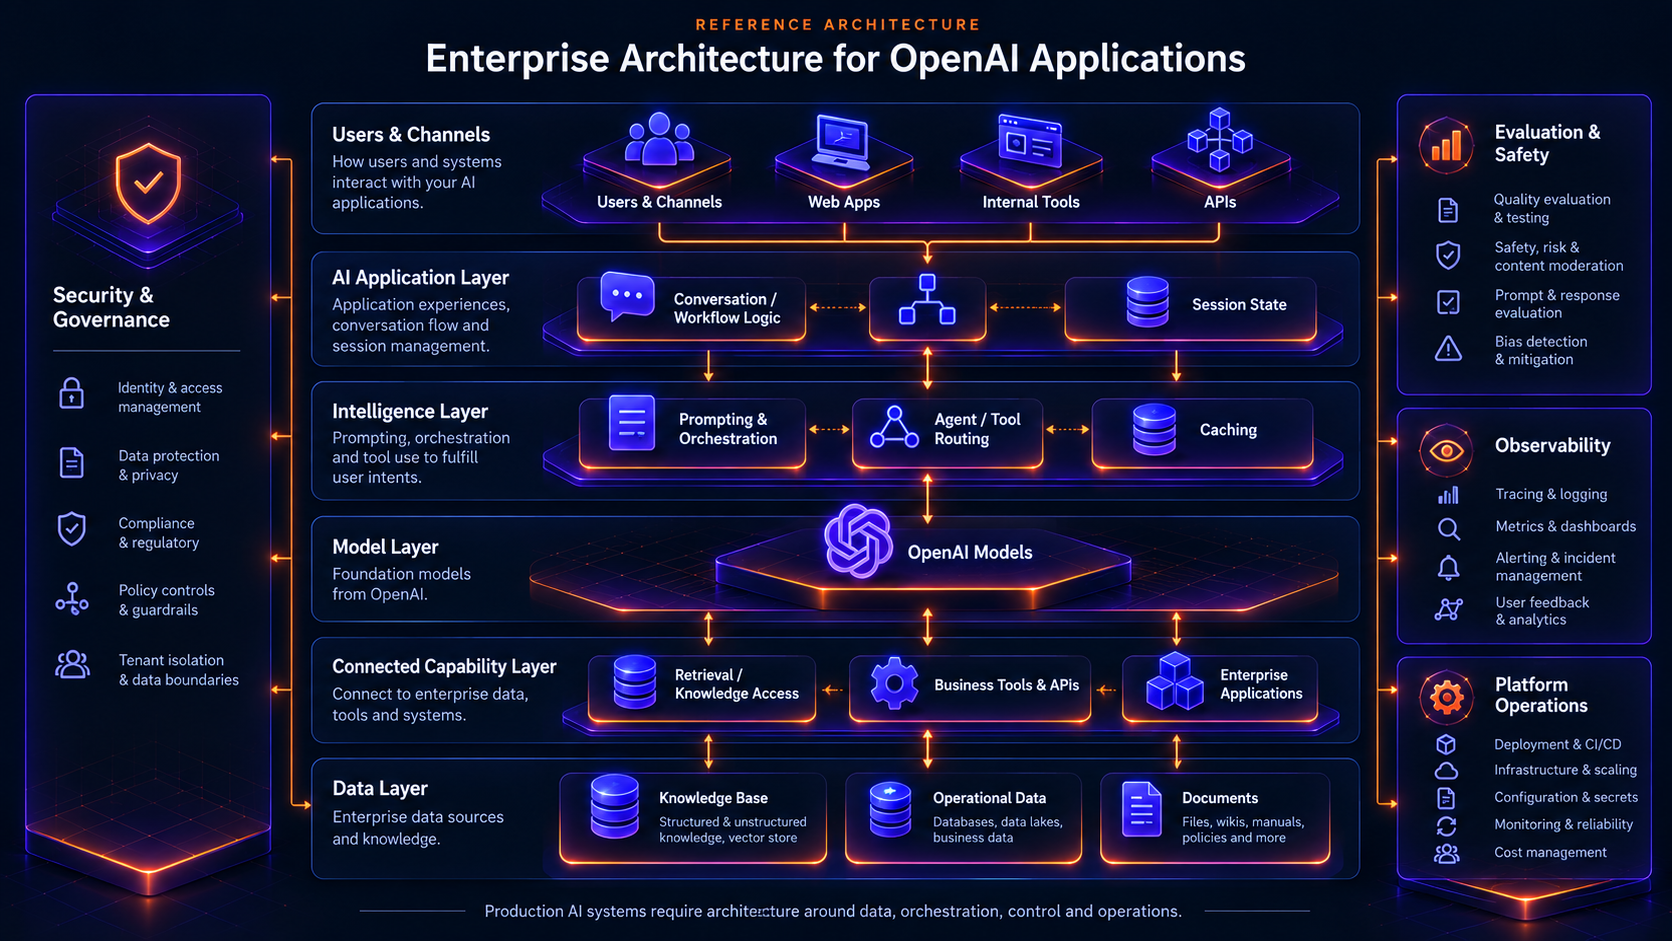
Nếu chỉ tập trung vào model, đội phát triển dễ bỏ qua những nguyên nhân thất bại phổ biến hơn: dữ liệu sai, retrieval không liên quan, phân quyền thiếu chặt chẽ, tool trả lỗi hoặc workflow không có đường fallback.
3. RAG không chỉ là “vector search + prompt”
RAG thường được mô tả đơn giản là tìm một số đoạn văn liên quan rồi đưa vào prompt. Trong hệ thống thật, chất lượng phụ thuộc vào cả một pipeline.
Ingestion và chuẩn hóa dữ liệu
Tài liệu có thể đến từ PDF, wiki, ticket, database hoặc document repository. Hệ thống cần xử lý cấu trúc, phiên bản, encoding, bảng biểu, quyền truy cập và lịch cập nhật.
Chunking và metadata
Chunk quá nhỏ làm mất ngữ cảnh; chunk quá lớn làm tăng nhiễu và token usage. Metadata như loại tài liệu, đơn vị sở hữu, thời gian hiệu lực và access group giúp retrieval chính xác hơn.
Retrieval và ranking
Semantic similarity chưa chắc đồng nghĩa với câu trả lời đúng. Tùy use case, pipeline có thể cần keyword search, metadata filtering, hybrid retrieval hoặc reranking.
Context assembly
Các đoạn được tìm thấy phải được sắp xếp, loại trùng và đặt vào context có cấu trúc. Hệ thống cũng phải nhận biết khi dữ liệu không đủ thay vì cố tạo câu trả lời.
Provenance và freshness
Với các use case cần kiểm chứng, output nên giữ được nguồn hoặc dấu vết dữ liệu. Index cũng phải được cập nhật khi tài liệu thay đổi; nếu không, câu trả lời có thể dựa trên chính sách đã hết hiệu lực.
RAG chỉ hoàn chỉnh khi có evaluation cho ingestion, retrieval và answer generation, chứ không chỉ kiểm tra câu trả lời cuối cùng.
4. Enterprise integration thường khó hơn prompt
Một AI assistant hiếm khi tạo giá trị chỉ bằng việc trò chuyện. Hệ thống thường cần đọc hoặc ghi dữ liệu qua:
- CRM và ERP
- internal APIs
- knowledge systems
- operational databases
- document repositories
- ticketing và workflow systems
Đây là nơi khác biệt giữa demo và production trở nên rõ ràng. Mỗi hệ thống có schema, authentication, permission, latency và failure mode riêng. API có thể timeout, dữ liệu có thể thiếu, workflow có thể yêu cầu approval hoặc một thao tác có thể tạo side effect không thể tùy tiện lặp lại.
Integration layer vì vậy cần contract rõ ràng: input nào hợp lệ, output nào được tin cậy, timeout bao lâu, retry khi nào và lỗi được trả về người dùng ra sao. Với thao tác ghi, cần cân nhắc idempotency, audit trail và approval step.
Prompt tốt không thể bù cho một integration boundary không được thiết kế rõ.
5. Evaluation phải được thiết kế trước khi scale
“Nhìn có vẻ đúng trong demo” không phải một evaluation framework. Trước khi mở rộng người dùng, đội phát triển cần định nghĩa hệ thống được coi là tốt dựa trên tiêu chí nào.
Một evaluation set nên phản ánh các nhóm input thực tế, bao gồm cả happy path, câu hỏi mơ hồ, dữ liệu thiếu, yêu cầu ngoài phạm vi và tình huống cần từ chối. Các tín hiệu thường cần theo dõi gồm:
- correctness
- groundedness
- relevance
- retrieval quality
- refusal behavior
- format compliance
- tool selection và tool result handling
Golden dataset không nhất thiết phải rất lớn ngay từ đầu, nhưng cần đủ đại diện và được quản lý phiên bản. Khi thay model, prompt, chunking, embedding, retrieval hoặc tool schema, bộ test phải giúp phát hiện regression.
Evaluation cũng nên kết hợp automated checks với human review cho các trường hợp mà chất lượng phụ thuộc mạnh vào ngữ cảnh nghiệp vụ. Mục tiêu không phải biến mọi đánh giá thành một con số duy nhất, mà là tạo một cơ chế quyết định thay đổi nào thực sự cải thiện hệ thống.
6. Security và authorization phải đi theo mô hình dữ liệu doanh nghiệp
Nếu một người dùng không được quyền đọc tài liệu trong hệ thống gốc, họ cũng không nên lấy được nội dung đó thông qua AI.
Điều này đòi hỏi authentication và authorization không chỉ ở giao diện ứng dụng mà xuyên suốt retrieval và tool execution. Identity của người dùng cần được truyền đúng vào các lớp truy cập dữ liệu. Filter quyền truy cập nên được áp dụng trước hoặc trong quá trình retrieval, không phải chỉ yêu cầu model “đừng hiển thị dữ liệu nhạy cảm”.
Một số điểm cần thiết kế rõ:
- ranh giới dữ liệu giữa user, team, tenant hoặc business unit
- cách xử lý dữ liệu nhạy cảm trong prompt và log
- quyền của từng tool
- secret management
- audit trail cho các hành động quan trọng
- retention và masking cho dữ liệu quan sát hệ thống
Model không phải security boundary. Quyền truy cập phải được đảm bảo bằng application logic và policy có tính quyết định.
7. Observability: production AI cần nhìn thấy điều gì đang xảy ra
Application log truyền thống vẫn cần thiết, nhưng chưa đủ. Một request AI có thể đi qua retrieval, nhiều model call và một số tool trước khi tạo phản hồi.
Observability nên giúp truy vết toàn bộ request flow, bao gồm:
- model latency và retrieval latency
- token usage và kích thước context
- lỗi API, timeout và rate limit
- tài liệu hoặc chunk được retrieve
- tool call và kết quả trả về
- failed retrieval hoặc empty context
- retry và fallback path
- tín hiệu chất lượng từ người dùng hoặc evaluator
Không phải mọi dữ liệu đều nên được log nguyên bản. Thiết kế observability phải cân bằng khả năng debug với privacy và data governance.
Điểm quan trọng là khi một câu trả lời không tốt xuất hiện, đội vận hành phải phân biệt được nguyên nhân nằm ở input, dữ liệu, retrieval, prompt, model, tool hay downstream system.
8. Cost và latency là quyết định kiến trúc
Chi phí và tốc độ không chỉ được tối ưu sau khi hệ thống hoàn thành. Chúng phụ thuộc trực tiếp vào cách thiết kế pipeline.
Một số quyết định có ảnh hưởng lớn:
- chọn model phù hợp theo từng loại tác vụ thay vì dùng một model cho mọi request
- giới hạn context vào thông tin thực sự liên quan
- cải thiện retrieval để giảm dữ liệu không cần thiết
- cache các kết quả phù hợp với policy dữ liệu
- dùng asynchronous workflow cho tác vụ dài
- đặt latency budget cho từng bước
- quản lý concurrency và rate limit
- dùng fallback khi upstream service không sẵn sàng
Model lớn hơn không tự động tạo ra hệ thống tốt hơn. Với các tác vụ phân loại, extraction hoặc routing có cấu trúc, một lựa chọn nhỏ hơn có thể phù hợp hơn. Với tác vụ cần reasoning phức tạp, hệ thống có thể dành ngân sách latency và compute cao hơn.
Tối ưu đúng bắt đầu bằng việc đo theo từng lớp, không chỉ nhìn tổng thời gian phản hồi.
9. AI agents cần boundary mạnh hơn chat application
Khi hệ thống chỉ trả lời, một lỗi có thể tạo thông tin không chính xác. Khi agent được phép gọi tool và thay đổi trạng thái bên ngoài, một lỗi có thể tạo side effect.
Vì vậy agent cần boundary rõ ràng:
- allowlist tool và action
- validation có tính quyết định trước khi thực thi
- giới hạn phạm vi dữ liệu và quyền
- approval của con người cho hành động nhạy cảm
- idempotency cho thao tác có thể retry
- timeout và số lần retry giới hạn
- audit log cho quyết định và tool call
- cơ chế dừng khi context không đủ
Không nên xem autonomy là mục tiêu tự thân. Mức tự động hóa phù hợp phụ thuộc vào rủi ro của hành động. Nhiều workflow hiệu quả nhất vẫn giữ human-in-the-loop tại điểm phê duyệt cuối.
10. Một production path thực tế
Một lộ trình triển khai có thể đi theo chuỗi:
Use case → Architecture → Data / Retrieval → Integration → Evaluation → Security → Pilot → Observability → Controlled rollout → Production operations
Đầu tiên, use case cần có phạm vi, người dùng và outcome rõ ràng. Sau đó mới thiết kế system boundary, nguồn dữ liệu, integration và evaluation criteria. Pilot nên chạy với nhóm người dùng giới hạn, dữ liệu đại diện và cơ chế feedback cụ thể.
Controlled rollout cho phép tăng dần traffic, quan sát failure mode và hiệu chỉnh guardrail. Khi vào production, hệ thống cần operational owner: ai theo dõi dashboard, xử lý incident, phê duyệt thay đổi prompt hoặc model và chịu trách nhiệm về evaluation regression.
Quá trình này có tính lặp. Dữ liệu từ production quay trở lại evaluation set; lỗi retrieval dẫn tới điều chỉnh ingestion; vấn đề latency có thể làm thay đổi model routing hoặc context strategy.
11. Khi nào một OpenAI PoC thực sự sẵn sàng cho production?
Có thể dùng checklist ngắn sau:
- [ ] Use case và business outcome đã rõ
- [ ] Nguồn dữ liệu và ownership đã được xác định
- [ ] Authentication và access control được áp dụng xuyên suốt
- [ ] Retrieval quality đã được kiểm thử trên dữ liệu đại diện
- [ ] Có evaluation dataset và regression test
- [ ] Integration đã được kiểm thử với failure cases
- [ ] Fallback và refusal behavior đã được định nghĩa
- [ ] Monitoring, tracing và alerting đã sẵn sàng
- [ ] Cost, latency và rate limit đã được hiểu
- [ ] Có operational owner và quy trình thay đổi
Nếu các điều kiện này chưa rõ, việc tăng traffic thường chỉ làm tăng tốc độ phát hiện vấn đề chứ không làm hệ thống production-ready hơn.
Kết luận
Khác biệt chính giữa một OpenAI PoC thành công và một hệ thống AI production không nằm ở việc demo tạo được câu trả lời ấn tượng đến đâu. Nó nằm ở kỷ luật engineering quanh architecture, data, retrieval, integration, evaluation, security và operations.
Model là thành phần quan trọng, nhưng giá trị bền vững xuất hiện khi toàn bộ hệ thống có thể truy cập đúng dữ liệu, tuân thủ đúng quyền, phản ứng có kiểm soát trước lỗi và được cải tiến dựa trên bằng chứng đo lường.
Ghi chú tác giả
Tác giả hiện làm việc tại TitanBases, OpenAI Select Partner có trụ sở tại Việt Nam, trong các dự án liên quan đến enterprise AI architecture, OpenAI integration, RAG, AI agents và production deployment.
Bài viết tổng hợp các góc nhìn kỹ thuật về việc đưa các OpenAI use case từ PoC lên hệ thống production trong môi trường doanh nghiệp.
All Rights Reserved